
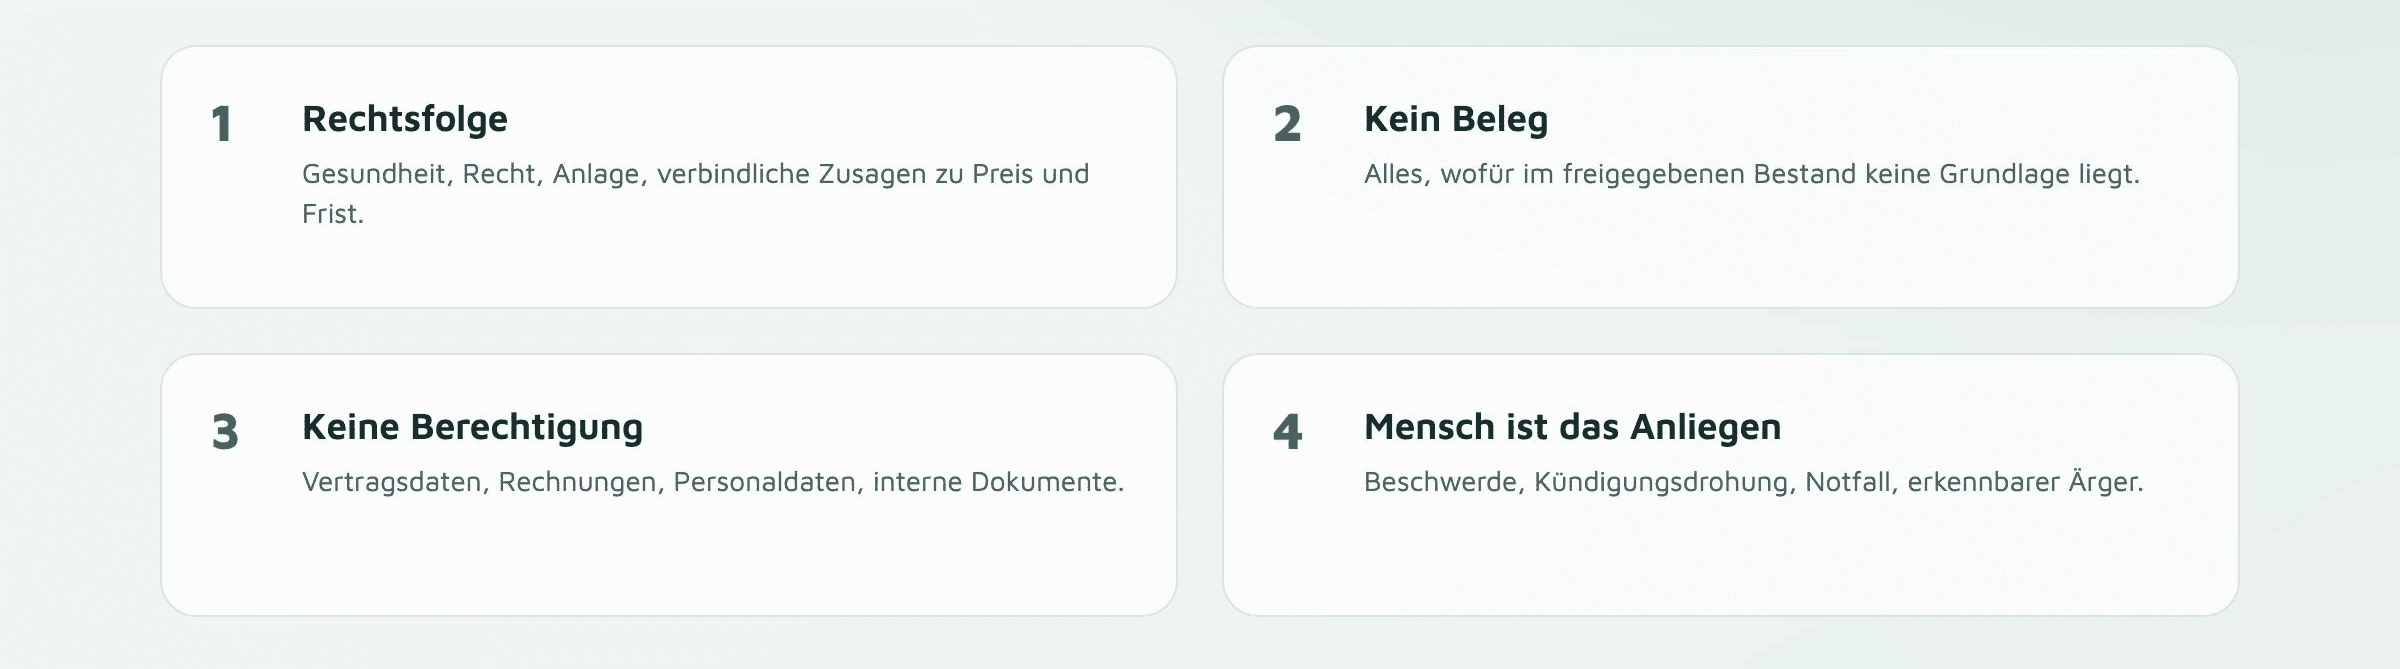
Ein Service-Chatbot sollte vier Arten von Fragen unbeantwortet lassen: Fragen mit Rechtsfolge, Fragen ohne belegte Quelle, Fragen außerhalb der Berechtigung des Gegenübers, und Situationen, in denen der Mensch selbst das Anliegen ist. In allen vier Fällen ist die richtige Ausgabe eine begründete Ablehnung mit Übergabe an einen Menschen.
Das klingt nach einer Einschränkung und ist in Wahrheit die Bedingung dafür, dass Nutzer den restlichen Antworten glauben. Ein Assistent, der jede Frage beantwortet, gibt seinem Gegenüber keinen Anhaltspunkt, welchen Auskünften es trauen kann.
Dieser Beitrag beschreibt, wie Sie die Grenze festlegen, wie eine Ablehnung formuliert wird und woran Sie messen, ob beides funktioniert.
Vier Kategorien außerhalb der Zuständigkeit
1. Fragen mit Rechtsfolge
Gesundheitsaussagen, Rechtsauskünfte, Anlageempfehlungen und verbindliche Zusagen zu Preisen, Fristen oder Konditionen. Was der Assistent hier sagt, ist eine geschäftliche Handlung des Unternehmens.
Das Oberlandesgericht Hamm hat im Mai 2026 entschieden, dass ein Unternehmen für die falschen Aussagen seines KI-Chatbots haftet und ihm die Ausgaben als eigene geschäftliche Handlung zugerechnet werden. Das Urteil ist noch nicht rechtskräftig, die Revision zum Bundesgerichtshof ist zugelassen. Die Richtung ist trotzdem eindeutig. Wer die Auskunft gegeben hat, trägt die Beweislast.
Details zur Rechtslage stehen in unserem Beitrag zur rechtlichen Zulässigkeit von KI-Chatbots.
2. Fragen ohne belegte Quelle
Alles, wofür im freigegebenen Bestand keine Grundlage liegt. Ein Modell erzeugt auch dann eine plausible Antwort, wenn es nichts weiß, und genau diese Antworten sind die gefährlichsten, weil sie sich von den richtigen sprachlich nicht unterscheiden.
Die Regel lautet: Fehlt der Beleg, endet die Auskunft. Das ist auch der Hebel, mit dem sich das Halluzinationsrisiko deutlich reduzieren lässt.
3. Fragen außerhalb der Berechtigung
Vertragsdaten, Rechnungen, Personaldaten, interne Dokumente. Die Frage ist beantwortbar, das Gegenüber ist dafür aber nicht legitimiert. Die Prüfung gehört vor die Generierung, damit ein vertrauliches Detail das Sprachmodell gar nicht erst erreicht.
Häufiger Fehler in der Praxis: Der Assistent prüft die Berechtigung erst beim Ausführen einer Aktion und plaudert vorher im Beratungsteil bereits Details aus.
4. Situationen, in denen der Mensch das Anliegen ist
Beschwerden, Kündigungsdrohungen, erkennbarer Ärger, Notfälle, verletzliche Gesprächspartner. Hier ist die inhaltlich richtige Antwort trotzdem die falsche Reaktion. Diese Fälle gehören sofort an einen Menschen, unabhängig davon, ob der Assistent die Frage beantworten könnte.
So legen Sie die Grenze fest
Die Liste entsteht nicht im Dialogdesign. Sie entsteht in einem Termin mit den Leuten, die im Zweifel geradestehen müssen.
Besetzung. Fachbereich, Rechtsabteilung oder Datenschutz, dazu die Person, die den Assistenten betreibt. Ohne die Rechtsseite bleibt die Liste ein Wunschzettel.
Ausgangsmaterial. Die 50 häufigsten Anliegen aus dem Ticketsystem und die Themen, bei denen im letzten Jahr etwas schiefgegangen ist. Reale Fälle schlagen erdachte Kategorien.
Entscheidung je Anliegen. Drei Zustände: der Assistent beantwortet es, er beantwortet es mit Beleg, oder er übergibt. Ein Zwischenzustand „vorsichtig formulieren" hält im Betrieb nicht.
Ergebnis. Eine versionierte Liste mit Datum und Freigabe, die dem System bekannt ist. Nicht ein Absatz im Briefing-Dokument.
Turnus. Alle drei Monate gegen die tatsächlichen Verläufe prüfen. Neue Produkte und neue Regulierung verschieben die Grenze.
Warum die Grenze außerhalb des Gesprächs liegen muss
Die verbreitete Umsetzung schreibt diese Liste als Verbote in den System-Prompt. Das trägt in den ersten Nachrichten und verliert danach an Wirkung, weil der Einfluss früher Kontextinhalte mit wachsendem Verlauf sinkt. Eine Grenze, die im Gespräch verrutschen kann, ist keine Grenze.
Was unabhängig von der Gesprächslänge trägt, sind drei Mechanismen im System: Antworten ausschließlich aus dem freigegebenen Bestand, ein Beleg für jede Aussage, und eine Berechtigungs- und Faktenprüfung als eigener Schritt vor der Ausgabe. Bei Mercury.ai läuft diese Prüfung in Mercury Intelligence, bevor generative KI überhaupt formuliert.
Wie eine Ablehnung formuliert wird
Eine gute Ablehnung nennt den Grund, zieht die Grenze klar und bietet den nächsten Schritt an. Sie entschuldigt sich nicht und sie erfindet keine Ersatzauskunft.
Schwach | Trägt |
|---|---|
„Das kann ich leider nicht beantworten." | „Zu gesundheitlichen Fragen darf ich keine Auskunft geben. Ich verbinde Sie mit unserer Kundenberatung." |
„Dazu habe ich keine Informationen." | „Zu diesem Artikel liegt mir kein Datenblatt vor. Ich lasse das von unserem Produktteam prüfen und Sie erhalten heute eine Antwort." |
„Bitte wenden Sie sich an den Support." | „Für Vertragsdaten muss ich Sie zuerst identifizieren. Möchten Sie sich anmelden, oder soll ich Sie an einen Kollegen übergeben?" |
„Ich bin nur ein Chatbot." | „Ich sehe, dass Sie das seit mehreren Tagen beschäftigt. Ich hole jemanden dazu, der den Fall abschließen kann." |
Drei Muster, die dabei helfen: den Grund vor der Ablehnung nennen, den nächsten Schritt konkret machen, und die Zuständigkeit benennen statt sie zu verschleiern.
Was bei der Übergabe mitgehen muss
Bei der Übergabe gehören mit:
der vollständige Gesprächsverlauf, damit niemand sein Anliegen zweimal schildert
der erkannte Intent und die Stelle, an der die Grenze griff
alles, was der Assistent bereits verifiziert hat, etwa Kundennummer oder Bestellnummer
ein Lösungsvorschlag, wenn das System einen hat
die Information, ob der Kunde angemeldet ist
In Agent Desk wandert der Verlauf mit, sodass die Person am anderen Ende dort einsteigt, wo der Assistent aufgehört hat.
Wenn außerhalb der Servicezeiten niemand übernehmen kann, gehört das in die Ablehnung: verbindlicher Rückrufzeitpunkt statt einer Warteschleife ins Leere.
Woran Sie messen, ob die Grenze trägt
Die Containment-Rate taugt dafür wenig. Sie steigt auch dann, wenn der Assistent Menschen abwimmelt.
Drei Kennzahlen sagen mehr:
Ablehnungsquote je Kategorie. Bleibt sie über Monate stabil, greift die Grenze. Fällt sie, ist der Assistent vermutlich gesprächiger geworden, als er sein darf.
Anteil abgeschlossener Übergaben. Wie viele der übergebenen Fälle schließt das Team, ohne beim Kunden nachzufragen. Das misst die Qualität des mitgegebenen Kontexts.
Regelbrüche pro tausend Gespräche, aufgeschlüsselt nach Gesprächslänge. Häufen sich Verstöße in langen Verläufen, liegt die Grenze noch im Prompt statt im System.
Nehmen Sie zusätzlich monatlich zwanzig echte Verläufe und lesen Sie sie. Ein Bot, der im Abnahmetest alles richtig macht und im Feld auffällt, zeigt das in den Verläufen früher als in jedem Dashboard.
Häufige Fragen
Verärgert eine Ablehnung nicht die Kunden?
Eine begründete Ablehnung mit funktionierender Übergabe kostet weniger Vertrauen als eine falsche Auskunft, die später korrigiert werden muss. Kritisch wird es erst, wenn die Ablehnung in einer Sackgasse endet.
Wie viele Themen sollte die Sperrliste umfassen?
So wenige wie möglich, formuliert als Kategorien statt als Einzelfälle. Lange Einzelfalllisten sind ein Zeichen dafür, dass die zugrundeliegende Regel fehlt.
Was ist mit dem Fall, dass der Assistent die Antwort eigentlich kennt?
Wenn die Auskunft in eine gesperrte Kategorie fällt, wird sie nicht gegeben. Die Grenze folgt der Zuständigkeit, nicht dem Wissensstand des Systems.
Muss der Nutzer erfahren, dass er mit einer KI spricht?
Ja. Die EU-KI-Verordnung verlangt Transparenz bei der Interaktion mit KI-Systemen. Das gehört an den Anfang und in die Ablehnung, wenn dort auf einen Menschen verwiesen wird.
Wie verhindere ich, dass die Grenze im Betrieb aufweicht?
Indem sie im System liegt und versioniert ist. Prüfen Sie bei jedem Release, ob die Sperrkategorien noch greifen, und testen Sie dabei mit langen Verläufen statt mit Einzelfragen.